蚂蚁开源 Ming 3.0 TTS:真强还是吹的?怎么装?
它能克隆声音,能用一句话造新声音,还会笑、会叹气。官网写着并列第一,我回榜单原网站对了一遍,数字已经变了。
本文的榜单数据查看于 2026 年 10 月 31 日,排名会变。安装步骤来自官方文档,我还没有在自己的电脑上实际安装。
它能做什么
Ming 3.0 TTS 是蚂蚁集团 Inclusion AI 开源的语音生成模型,使用 MIT 许可。官方介绍的主要能力有:
- 克隆:给一小段参考音频,学会这个声音。
- 造声音:不用参考音频,用文字描述生成新声音。
- 导演模式:用大白话指定情绪、节奏和重音。
- 副语言标签:把笑声、叹气、咳嗽写进台词。
- 语言:中、英、日、韩、法、德、西七种语言,加四川话和粤语。
榜单成绩:官网和今天不一样
官网的成绩来自第三方机构 Artificial Analysis,官网也注明了排名会随新模型变化。下面是我当天在原网站看到的结果:
| 榜单 | 官网写的 | 2026-10-31 原网站 |
|---|---|---|
| 发音(Pronunciation Robustness) | 93.2%,并列第一 | 93.2%,排第二;第一是 Fish Audio Drama 3(94.6%);高于 Eleven v4(91.7%) |
| 克隆同一声音比听感(Controlled Voice) | 开源第 1,总榜第 13 | 开源第 2,总榜第 17 |
| 各用自家音色比听感(Provider Voice) | 开源第 3,总榜第 17 | 开源第 4,总榜第 24 |
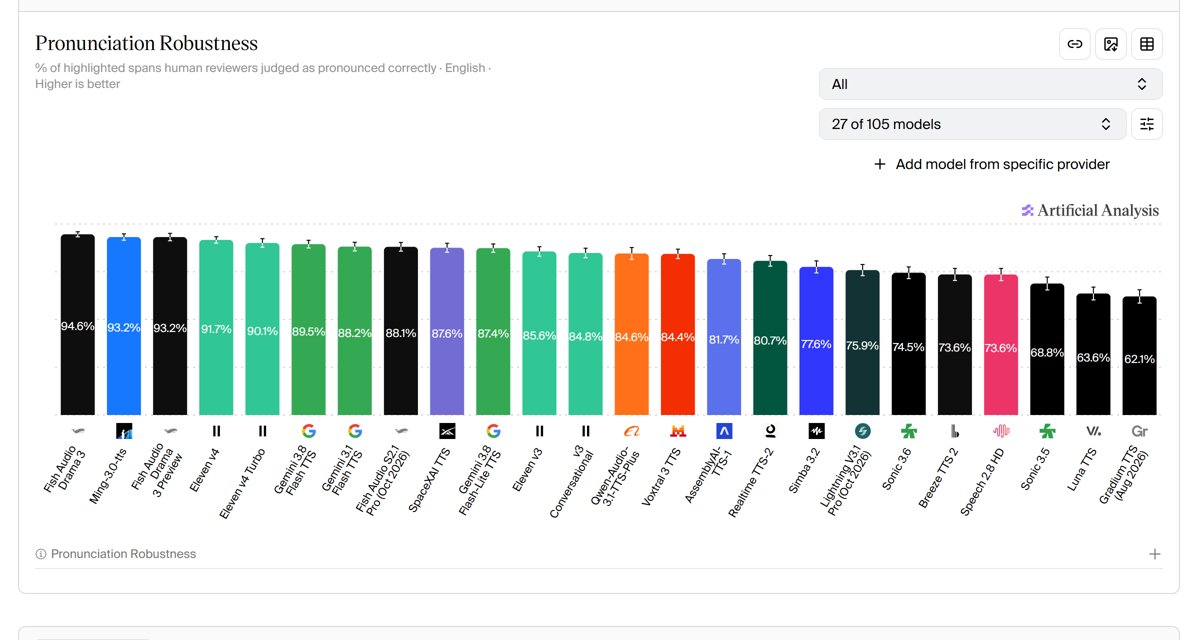
我的判断:发音准是真的,开源模型里也有竞争力,但在听感上还算不上总榜顶尖。
中文要自己听
发音榜和克隆榜的默认成绩考的都是英文。我把克隆榜切到 Mandarin(普通话),当天列表里没有 Ming。所以它的中文表现,这些榜单回答不了,最好拿自己的稿子试。
两个版本怎么选
| 版本 | 参数 | Hugging Face 仓库大小 | 说明 |
|---|---|---|---|
| 0.5B | 5 亿 | 约 3GB | 除多人对话外都能做 |
| Tiny | 总共 79 亿,激活 13 亿 | 约 18GB | 支持多人对话,要单独的环境 |
别被名字骗了,Tiny 反而是大的。不做多人对话,先用 0.5B。
显存:官方没有写显存要求,只写了 0.5B 在 NVIDIA H800-80GB 和 H20-96G 上测试过。有视频作者在 RTX 4070 Ti 上看到约 2.1GB 占用,但这只是一次个人测试,不能当成官方要求。
官方安装步骤
1. 下载代码,安装依赖
git clone https://github.com/inclusionAI/Ming-3.0-tts.git
cd Ming-3.0-tts
pip install -r requirements.txt
Tiny 要单独建环境:
conda create -n ming-tiny python=3.10.15 -y && conda activate ming-tiny
pip install -r requirements-tiny.txt
2. 下载模型
pip install "huggingface_hub[cli]"
hf download inclusionAI/Ming-3.0-tts-0.5b --local-dir Ming-3.0-tts-0.5b
官方说中国大陆用魔搭通常更快:
pip install modelscope
modelscope download --model inclusionAI/Ming-3.0-tts-0.5b --local_dir Ming-3.0-tts-0.5b
3. 文本规范化(可选)
conda install -c conda-forge pynini==2.1.6它用来处理数字、日期和单位。装不上的话,运行时加 --no_text_normalization 跳过。
4. 自检
python tools/preflight.py --model_path /path/to/Ming-3.0-tts-0.5b5. 生成第一条配音
python infer.py \
  --model_path inclusionAI/Ming-3.0-tts-0.5b \
  --task TTS \
  --language_id Chinese \
  --text "傍晚的风从山口吹过来,远处的云慢慢染成了金色。" \
  --prompt_wav_path data/voice_presets/voice_audio/lingguang.wav \
  --prompt_text "诶,你今天有空吗?我们能不能聊聊这件事啊?" \
  --use_spk_emb \
  --output output/tts.wav
官方自己写的短板
- 音高是两个模型最不准的属性。
- 台词本身不带情绪时,情绪准确率会明显下降。
- 官方要求不得未经同意模仿真人,也不得用于欺骗或违法用途。
值不值得试
想要开源、能本地跑、英文发音准,值得试。要做中文配音,先拿自己的稿子听一遍再决定。